اپل با معرفی یک مدل زبانی پیشرفته مبتنی بر معماری Diffusion، گامی بزرگ در جهت افزایش سرعت تولید متون طولانی و پیچیده برداشته است. بر اساس گزارشهای منتشر شده، این مدل نوین قادر است متنها را تا ۱۲۸ برابر سریعتر از مدلهای همساز تولید کند، با حفظ دقت و کیفیت بالا.
تفاوت بنیادین: معماری Diffusion در برابر خودرگرسیو
مدلهای زبانی بزرگ رایج مانند ChatGPT از نوع خودرگرسیو (Autoregressive) هستند. این مدلها متن را به صورت توکنبهتوکن و ترتیبی میسازند، به طوری که تولید هر توکن جدید وابسته به تمام توکنهای قبلی است. این فرآیند ذاتاً زمانبر است، بهویژه برای متون طولانی.
🔗 بیشتر بخوانید: جزئیات دوربین پریسکوپ ۲۰۰ مگاپیکسلی شیائومی ۱۵ اولترا آشکار شد_اسپایدر
در مقابل، مدلهای Diffusion چندین توکن را بهصورت همزمان تولید کرده و سپس در مراحل تکراری متعدد آنها را اصلاح میکنند تا به خروجی نهایی برسند. یکی از پیشرفتهترین رویکردها در این حوزه، Flow-matching است که تلاش میکند با حذف مراحل اصلاح متعدد، نتیجه نهایی را در یک گام یا تعداد معدودی از گامها به دست آورد.
معرفی مدل FS-DFM: پیشرفت در روش Few-Step Diffusion
مقاله تحقیقی اخیر اپل با عنوان «FS-DFM: Fast and Accurate Long Text Generation with Few-Step Diffusion Language Models»، مدل نوینی به نام Few-Step Discrete Flow-Matching (FS-DFM) را معرفی میکند. این مدل میتواند متون طولانی را تنها با هشت مرحله اصلاح و با سرعت بسیار بالا تولید کند، در حالی که مدلهای Diffusion معمولی برای دستیابی به کیفیت مشابه، اغلب بیش از هزار مرحله را ضروری میدانستند.
🔗 بیشتر بخوانید: بین منفعت گیری از اینترنت و زندگی بهتر رابطه وجود دارد_اسپایدر
استراتژیهای کلیدی افزایش سرعت
تحقیقگران اپل برای دستیابی به این عملکرد، از سه رویکرد اصلی بهره بردهاند:
- آموزش مدیریت مراحل: مدل طوری آموزش میبیند که فرآیند اصلاح متن را در تعداد محدودی از مراحل به خوبی مدیریت کند.
- استفاده از مدل «معلم»: یک مدل معلم برای انجام بهروزرسانیهای دقیقتر و مقیاسبزرگتر در هر مرحله به کار گرفته شده است.
- بهینهسازی اجرای مراحل: نحوه اجرای هر مرحله بهینه شده تا مدل بتواند با گامهای کمتر و اطمینان بیشتر به نتیجه نهایی برسد.
ارزیابی عملکرد: برتری در معیارهای کیفی
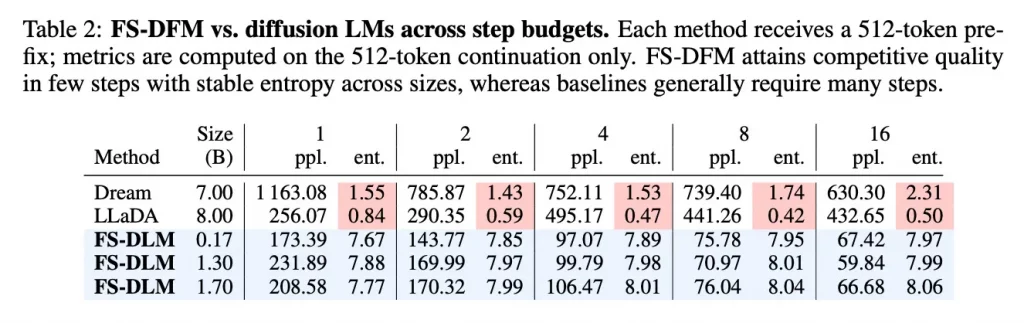
در مقایسه با مدلهای همساز بزرگ، FS-DFM در دو معیار حیاتی «آنتروپی» و «سردرگمی» (Perplexity) عملکرد قابلتوجهی داشته است:
- سردرگمی (Perplexity): این معیار کیفیت و طبیعی بودن متن را اندازه میگیرد. هرچه مقدار آن پایینتر باشد، متن تولیدشده منسجمتر و دقیقتر است.
- آنتروپی (Entropy): نشاندهنده اطمینان مدل در انتخاب کلمات است. مقدار پایین منجر به متنهای تکراری و پیشبینیپذیر میشود، در حالی که مقدار بالا باعث نامنسجم یا تصادفی شدن متن میگردد. FS-DFM تعادل ایدهآلی در این معیار برقرار کرده است.
مدل FS-DFM با اندازههای پارامتره ۱.۷ میلیارد، ۱.۳ میلیارد و ۱۷۰ میلیون، در مقایسه با مدلهای رقیب مانند Dream و LLaDA که دارای ۷ و ۸ میلیارد پارامتر هستند، مقدار پایینتری در سردرگمی و نتیجه پایدارتر و متعادلتری در آنتروپی ثبت کرده است. این امر نشاندهنده کارایی بالا و بهینه بودن معماری پیشنهادی است، حتی با تعداد پارامترهای بسیار کمتر.
منابع باز و آینده تحقیق
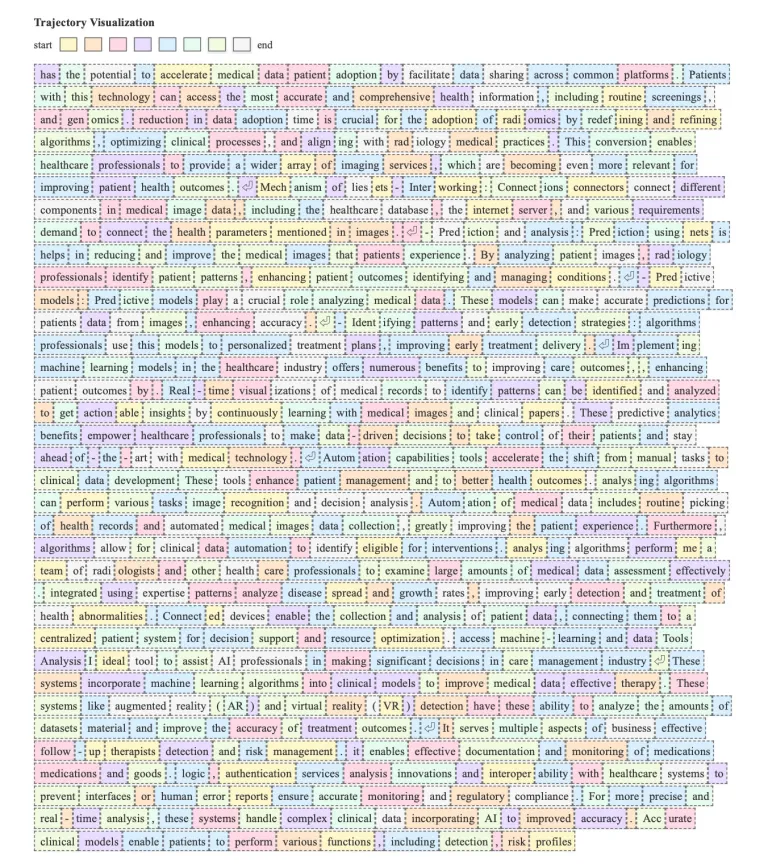
با توجه به عملکرد برتر و کارایی مدلهای پیشنهادی، تیم تحقیقاتی اپل قصد دارد کدها و چکپوینتهای مدل را به صورت باز (Open Source) منتشر کند تا امکان بازتولید نتایج و تحقیقات گستردهتر برای جامعه علمی فراهم آید. مطالعه کامل مقاله شامل مثالهای عملی، نمودارها و تحلیلهای دقیق مراحل اصلاح توکنها در arXiv در دسترس است.


